Google gibt Gemini ein Gesicht: Live-Avatar spricht 97 Sprachen in Echtzeit
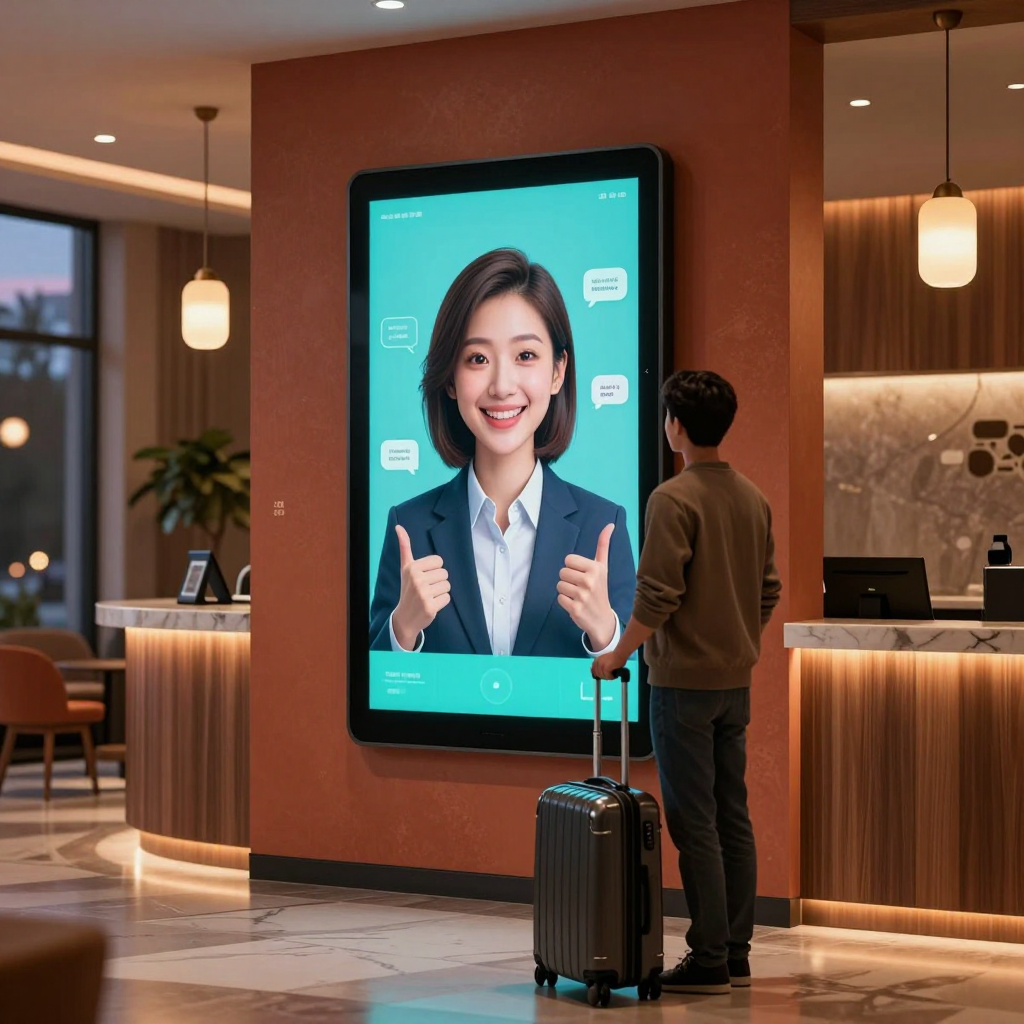
Nachrichtenzusammenfassung
Google hat seiner live geführten Konversations-KI ein Gesicht gegeben. Am 24. September 2026 führte das Unternehmen Gemini 3.8 Live mit Live-Avatar ein, eine Funktion, die der Sprache seiner nativen Dialogmodelle nahezu in Echtzeit generiertes Video hinzufügt, und Googles Cloud-Blog listet sie als allgemein verfügbar am 25. September in Gemini Enterprise auf, mit Endpunkten in den Vereinigten Staaten und der Europäischen Union. Ein Agent kann nun zuhören, sehen und sprechen durch eine reaktionsfähige Bildschirmpersona statt nur durch eine Stimme. Die Verge-Seite, die die Geschichte zuerst aufgriff, konnte für diesen Bericht nicht abgerufen werden, daher stammen die folgenden Details aus Googles eigenen Ankündigungen und unabhängiger Berichterstattung.
Was Live-Avatar tut
Live-Avatar kombiniert Googles natives Sprache-zu-Sprache-Dialogmodell mit latenzarmem Streaming-Video. Das generierte Gesicht führt Lippensynchronisation und Gesichtsausdrücke aus, die der synthetisierten Stimme folgen. Das System übernimmt auch die Gesprächsübergabe, sodass ein Benutzer unterbrechen kann und der Agent sich natürlich erholt.
Die Engine nimmt gleichzeitig Sprach- und visuelle Eingaben auf. Ein Avatar kann daher einen Kamerastream oder geteilten Bildschirm eines Benutzers betrachten, während er spricht. Google sagt, dies ermögliche Unternehmen, virtuelle Angebote wie Kundenservice und interaktive Rundgänge zu erweitern.
Sprachen und Werkzeugnutzung
Google sagt, die Funktion unterstütze native mehrsprachige Sprache-zu-Sprache-Synchronisation über 97 Sprachen, mit automatischer Spracherkennung. Wenn ein Gespräch von einer Sprache in eine andere wechselt, passen sich Lippensynchronisation und Ausdrücke dynamisch an. Ein Rezensent merkt an, dass die mehrsprachigen Behauptungen nicht unabhängig überprüft wurden.
Asynchrones Werkzeugaufrufen ermöglicht es dem Agenten, Werkzeuge aufzurufen und Daten im Hintergrund abzurufen, während das Gespräch weiterläuft. Komplexe Aufgaben, wie das Durchsuchen von Beständen oder das Nachschlagen von Kontodetails, müssen den Dialog nicht unterbrechen.
Voreingestellte und benutzerdefinierte Avatare
Organisationen können aus einer Bibliothek voreingestellter Avatare wählen. Benutzerdefinierte Avatare sind auf ausgewählte Unternehmenskunden über eine Positivliste beschränkt. Laut Berichterstattung über die Bedingungen erfordern benutzerdefinierte Avatare eine verifizierte Einwilligung für das Referenzbild und verbieten Bilder von Minderjährigen, Prominenten oder anstößigen Inhalten. Unternehmen müssen auch die erforderlichen Rechte sichern. Eine Extended-Thinking-Variante des Modells bleibt in privater Vorschau.
Frühe Kunden
Googles Ankündigung nennt mehrere frühe Anwender. Cox Automotive, das Unternehmen hinter Autotrader, baut einen KI-Einkaufsassistenten, der Artikel auf dem Bildschirm für Fahrzeugsuche und Finanzierung hervorhebt. Equal AI betreibt einen persönlichen Assistenten, der mehr als eine Million Anrufe pro Tag in neun indischen Sprachen bearbeitet. Salesforce integriert die Technologie mit Agentforce, und Specs berichtet von besserer Sprachaktivitätserkennung und geringerer Latenz.
Preisgestaltung und praktische Grenzen
Es gibt kein Verbraucher-Abonnement. Die Preisgestaltung erfolgt pro Token für Unternehmens-API-Nutzer. Laut einer unabhängigen Analyse kostet Texteingabe 0,75 US-Dollar pro Million Token, Audioeingabe 3 US-Dollar und Bild- oder Videoeingabe 1 US-Dollar. Textausgabe kostet 4,50 US-Dollar, Audioausgabe 12 US-Dollar und Avatar-Videoausgabe 1 US-Dollar pro Million Token. Avatar-Video läuft mit 24 Bildern pro Sekunde und konvertiert zu etwa 6.192 Token pro Sekunde Sprechen, was die Analyse auf etwa 0,37 US-Dollar pro Minute Avatar-Sprache schätzt, plus etwa 0,018 US-Dollar pro Minute für Audioausgabe.
Dieselbe Analyse sagt, dass kontinuierliche Sitzungen derzeit nur wenige Minuten dauern. Das eignet sich für begrenzte Aufgaben wie Hotel-Check-ins oder kurze Support-Gespräche, aber nicht für lange Nachhilfe- oder Beratungssitzungen. Sitzungskontext wird bei jeder Runde neu verarbeitet und abgerechnet.
Sicherheit und Transparenz
Alle von Googles KI-Produkten generierten Audio- und Videoinhalte tragen ein unsichtbares SynthID-Wasserzeichen, das hilft, KI-generierte Inhalte zu identifizieren. Das Wasserzeichen ist jedoch unsichtbar, sodass es allein nicht garantiert, dass Benutzern mitgeteilt wird, dass sie mit einer KI sprechen. Unternehmen, die Avatare einsetzen, benötigen ihre eigene klare Offenlegung. Engadgets Schlagzeile nannte die Avatare "gruselig", eine Erinnerung daran, dass Reaktionen auf lebensechte synthetische Gesichter gemischt sind.
Warum es für Lernende wichtig ist
Gesichter lassen Sprachassistenten mehr wie ein Gespräch wirken, was bei Sprachpraxis, geführten Software-Rundgängen und interaktivem Training helfen könnte. Die Technologie zeigt auch, wie schnell Sprache, Sehen und Videogenerierung in einem einzigen Echtzeitmodell kombiniert werden. Bereitgestellter Durchsatz ist für Hochvolumen-Bereitstellungen verfügbar, und der Google Cloud Vertrieb übernimmt die Positivlistung für benutzerdefinierte Avatare. Entwickler können die Funktion in der Gemini Enterprise Konsole ausprobieren und die Gemini Live API Dokumentation lesen.
Quellen
Die Berichterstattung stützt sich auf Googles Cloud- und Produktblogs, Unite.AI, Engadget, Fone Arena, Android Headlines, TestingCatalog, TechEBlog und Choosely. Alle Daten beziehen sich auf Ankündigungen in US-Westküstenzeit, sofern nicht anders angegeben, und Googles Blog datiert die allgemeine Verfügbarkeit auf den 25. September 2026.